社内データを誰もが活用できる未来へ、自社データ基盤への取り組み
こんにちは、プロダクト開発本部の木谷です。
現在弊社では自社内に存在するデータを開発組織以外でも活用できるようにするため、データ基盤構築プロジェクトを進めています。
今回は最近のプロダクト開発本部の取り組み紹介も兼ねて、直近注力しているデータ基盤プロジェクトについて「なぜ必要なのか」「どのような未来を実現できるのか」をまとめていきます。
データ基盤プロジェクト始動の背景
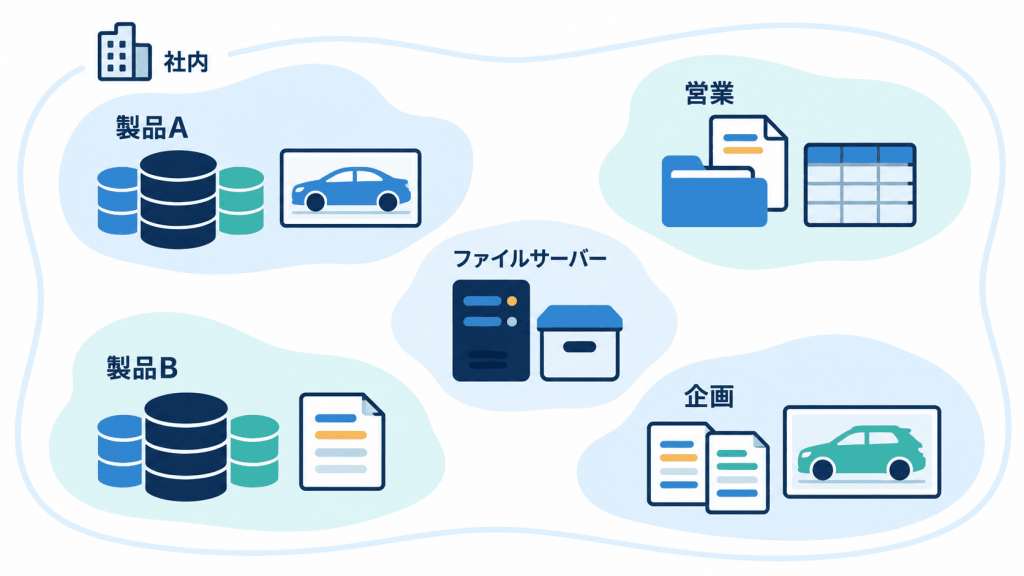
当社には、30年以上の事業活動を通じて蓄積されたデータが、製品ごとのデータベースやファイルサーバに分散して存在しています。価値のあるデータを保有している一方で、必要な人が必要なときに製品を横断して利用できる状態にはなっていません。例えば、セールス部門がデータ利用する際にはプロダクト開発本部へ依頼いただく必要があるのですが、現状はどのようなデータがあるか可視化されていない中でほしいデータを定義し依頼する必要があります。データ基盤の構築によりこのような課題を解消し、社内の誰もが適切な権限のもとでデータを活用できる環境作りを行います。
また、弊社にはメイン事業であるsymphonyシリーズと呼ばれる中古車販売店の業務効率化を支援するプロダクト群が存在します。こちらは前身のサービスから数えて20年以上開発・運営されているサービスです。 同サービスには過去から蓄積された膨大な量の取引データや中古車データのようなトランザクションデータが保管されています。また、symphonyシリーズの提供以外にも弊社では自社で独自作成した自動車マスタ・カタログデータの提供や運用も行っており、自社内で生成されたマスタやカタログデータも多く保有しています。 これらのデータは弊社独自の強みとなるため、効率的に活用できる環境を作り、価値のあるソリューションの創出と提供が迅速にできるようにするというのも、本プロジェクトの目的の一つです。
データ基盤の概要紹介と弊社における定義
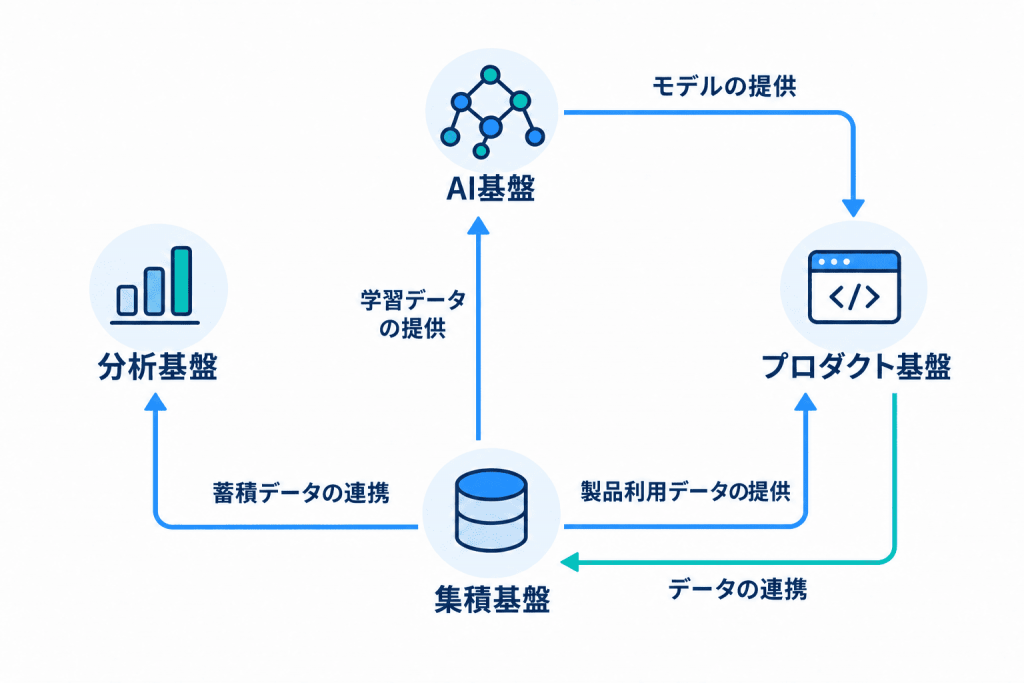
ここまで背景を話してきましたがここからはデータ基盤とは何か、についての説明です。
データ基盤とはざっくりいうと”自社内に存在するデータを一か所に集め、整理し効率的に活用できるようにする”ためのものです。
この開発を進めるにあたり、弊社ではデータ基盤を”集積”,”分析”, “AI学習” ,”製品転用”の4つの要素に分け、担当を割り当て開発を進めています。
社内では以下のような呼称でそれぞれを定義しています。
- 集積基盤
- 分析基盤
- AI基盤
- プロダクト基盤
集積基盤
まず「集積基盤」は社内に点在するデータをデータ基盤内に集める処理を行います。
ここでいう”データ”はDBのレコードのほか、ファイルやログデータなどあらゆるデータを指します。
先にも記載した通り、かなりの量のデータが社内にあるので整理するだけでもかなり大変ですが、30年間蓄積された不要なデータの断捨離もできるのでこれで身が軽くなるとうれしいなという想いもあります。
ここで集めたデータがこの先の分析基盤やプロダクト基盤で利用されるためキモになる部分です。
分析基盤
分析基盤では、集積基盤によって取り込まれたデータを、分析やAI活用に適した形へ段階的に整備します。
当社では、メダリオンアーキテクチャの考え方に基づき、データをBronze、Silver、Goldの3層に分け、品質と利用しやすさを高めていきます。
Bronzeレイヤー
各システムから取り込んだデータを、原則として元の状態に近い形で保存する層です。
履歴を保持することで、処理のやり直しやデータの出所の確認を可能にします。Silverレイヤー
Bronzeのデータに対して、重複排除、欠損値や表記揺れの補正、形式の統一、データ同士の結合などを行う層です。
分析に利用できる、品質のそろった明細データを整備します。Goldレイヤー
Silverのデータを、売上分析や顧客分析などの業務目的に合わせて集計・再構成する層です。
ダッシュボードやレポート、AI、各種プロダクトから利用しやすい形へ整えます。
SilverとGoldの設計では単に技術的にデータを加工するだけでなく、各部門で使われている用語や指標の定義をそろえる必要があります。
そのため、プロダクト開発本部だけで完結させるのではなく、実際にデータを利用するビジネス部門と協力しながら会社で一丸となり整備を進める部分です。
整備したデータはDatabricksなどの分析環境から利用できるようにし、専門知識が少ない社員でも自然言語を入口としてデータを探索・分析できる環境を目指します。
また、ここでのデータ加工時にセンシティブな情報のマスキングやデータにアクセスできるユーザーの権限管理などの対応も行います。
AI基盤
AI基盤では、データ基盤上に存在するデータを用いて独自AIモデルの構築やチューニングを行います。
現在は、例えば画像データとカタログデータを掛け合わせデータ入力を効率化するといった処理をAIに実行させる場合、既に存在するモデルに対してプロンプトでの指示や最適化を図っているもののモデル自体を改善できる環境が存在していません。そのため汎用モデルの性能に依存してしまい、提供価値には上限があります。
そこでデータ基盤内にAI基盤を設け、自社独自のモデルを構築できる環境を整備します。さらに、後述するプロダクト基盤などから収集したフィードバックデータをモデルのチューニングに活用し、精度を継続的に向上させるフィードバックループを実現します。
プロダクト基盤
最後はプロダクト基盤です。 プロダクト基盤は、収集・整備したデータを実際のサービスや業務機能として提供するための基盤です。
自社で保有する自動車マスタやカタログデータ、各製品のデータを組み合わせ、API、検索・マッチング機能、AIを活用した機能など、新たなソリューションの開発につなげます。
最初のマイルストーンとして、現在社内で行われている複数マスタ間のマッチング処理の効率化やマスタ・カタログデータ生成の効率化に取り組んでいます。
データ基盤がある未来とは
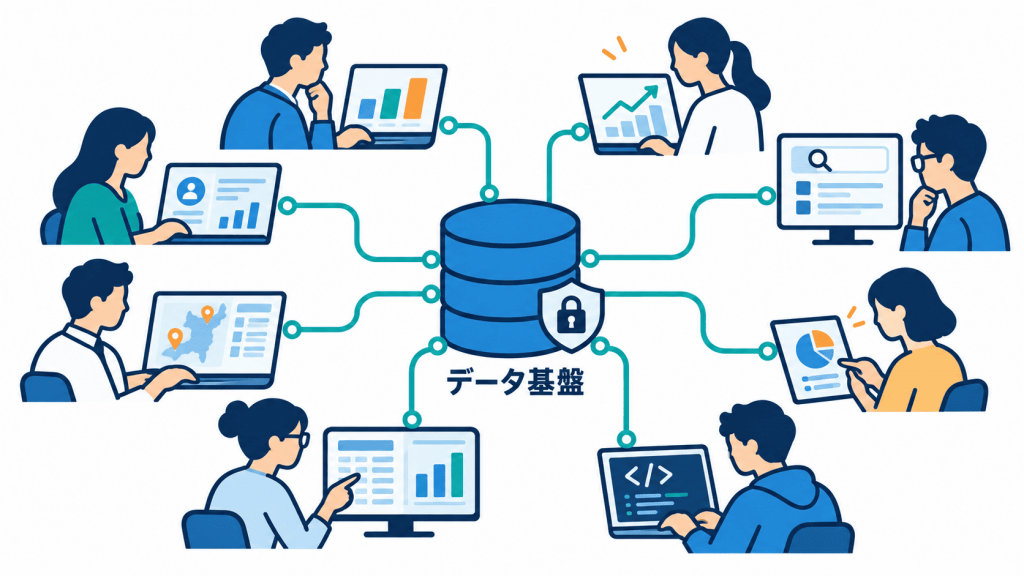
データ基盤プロジェクトで実現したい未来は「データの民主化」です。
昨今はAIエージェントの台頭もあり、情報の入出力に必要なインターフェースは固定されなくなってきています。近い将来、どこからでも自社で保有するデータにセキュアかつ楽に接続でき、ビジネスに生かすことのできる環境が当たり前になると思っています。
そういった未来にいち早く到達し、価値提供できるようになることがデータ基盤プロジェクトの目指すところです。そのためにもまず「すべての社員が自社データを日々の業務で活用できるようになる」状態を目指しています。
具体的には、以下のような状態です。
- 営業担当者が顧客や市場の傾向を自ら確認し、AIを用いて分析できる
- 企画者が複数製品の利用状況を横断して分析したり、新機能の仮説検証を短期間で行えるようにする
これらの今期中の実現をマイルストーンに置き、取り組みを進めています。
本記事では、データ基盤プロジェクトを開始した背景と、私たちが目指している将来像をご紹介しました。
今後は、集積基盤、分析基盤、AI基盤、プロダクト基盤の各領域について、採用した技術や設計上の工夫、開発中に直面した課題などを紹介していく予定です。
ファブリカコミュニケーションズで働いてみませんか?
あったらいいな、をカタチに。人々を幸せにする革新的なサービスを、私たちと一緒に創っていくメンバーを募集しています。
ファブリカコミュニケーションズの社員は「全員がクリエイター」。アイデアの発信に社歴や部署の垣根はありません。
“自分から発信できる人に、どんどんチャンスが与えられる“そんな環境で活躍してみませんか?ご興味のある方は、以下の採用ページをご覧ください。